- Kierowca dostępny teraz
- całą dobę, 7 dni w tygodniu
- Dojazd do 1 h w promieniu 40 km
- Diagnoza laptopa 0 zł

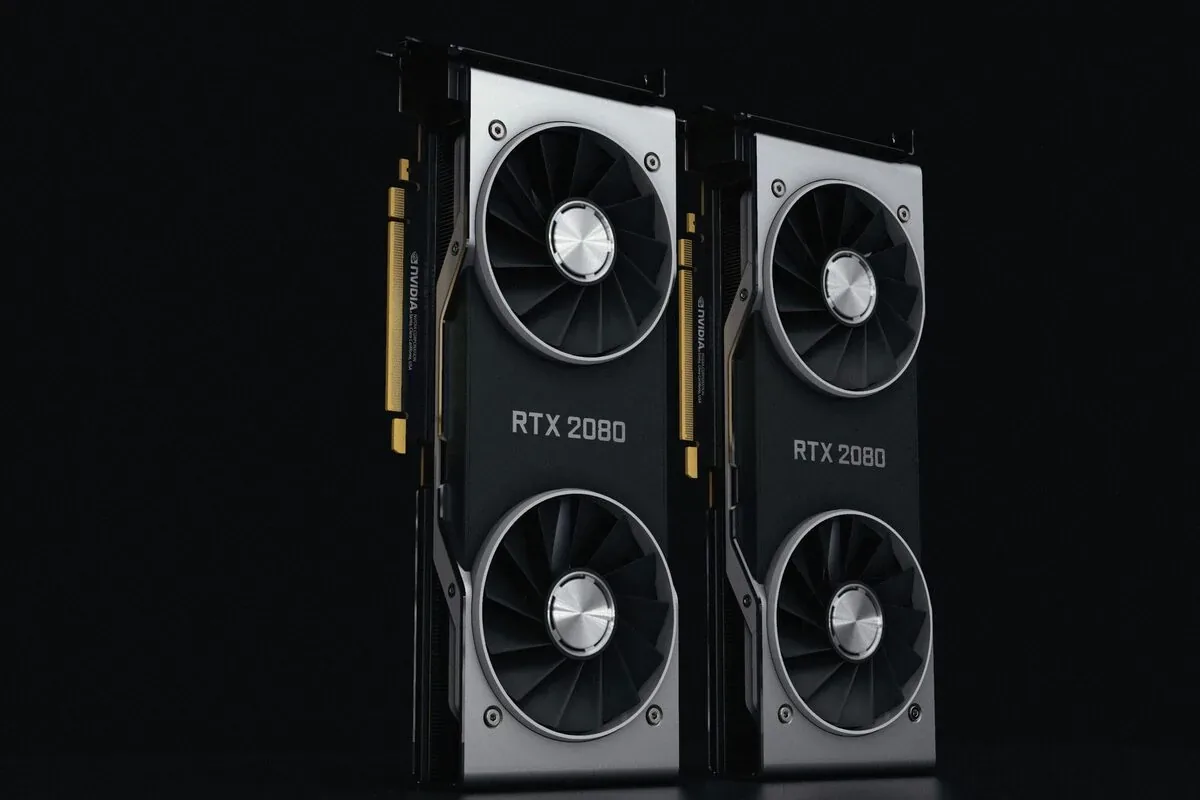
Wydajność pracy z lokalnym modelem AI w dużej mierze zależy od karty graficznej — jej pamięci i mocy obliczeniowej — dobór odpowiedniego modelu karty pozwala uniknąć rozczarowania po instalacji.
Usługa obejmuje analizę wymagań planowanego modelu AI, doradztwo w doborze karty graficznej o odpowiedniej pamięci i mocy obliczeniowej oraz — na życzenie — pomoc przy jej montażu w komputerze.
Usługa jest przydatna dla osób i firm planujących pracę z bardziej wymagającymi modelami AI, które chcą dobrać kartę graficzną adekwatną do realnych potrzeb, bez przepłacania.
Doradztwo w doborze karty graficznej mieści się z reguły w standardowym czasie do 3 dni, wraz z ewentualnym montażem.
Diagnoza wstępna i wycena są bezpłatne. Dojazd na terenie Warszawy i okolic jest bezpłatny, a usługa objęta jest gwarancją do 12 miesięcy.
Wybór karty graficznej dedykowanej do pracy z lokalnymi modelami sztucznej inteligencji różni się od kryteriów stosowanych przy doborze podzespołów do gier komputerowych lub tradycyjnej obróbki wideo. W obliczeniach związanych z sieciami neuronowymi kluczowe znaczenie mają parametry odpowiadające za pojemność i szybkość transferu danych oraz wyspecjalizowaną architekturę rdzeni obliczeniowych.
Najważniejszym czynnikiem jest pojemność pamięci VRAM (Video Random Access Memory, dedykowana pamięć wideo karty graficznej). Cała struktura wag modelu sztucznej inteligencji (parametrów określających zachowanie sieci neuronowej) oraz bufor kontekstu muszą zmieścić się bezpośrednio w pamięci podręcznej układu graficznego. Jeżeli model nie mieści się w pamięci VRAM, jego fragmenty muszą być przenoszone do pamięci operacyjnej RAM komputera poprzez magistralę płyty głównej, co powoduje gwałtowny spadek prędkości generowania odpowiedzi.
Drugim kluczowym parametrem jest przepustowość pamięci wideo (mierzona w gigabajtach na sekundę, określająca szybkość przesyłania danych między pamięcią VRAM a rdzeniem graficznym). Architektury o szerokiej szynie danych (na przykład 256-bitowej lub 384-bitowej) zapewniają znacznie szybsze odczytywanie wag modelu podczas każdego kroku generowania tekstu lub obrazu, co bezpośrednio przekłada się na liczbę przetwarzanych tokenów (podstawowych jednostek tekstu, takich jak słowa lub ich fragmenty) na sekundę.
Trzecim elementem jest obecność i generacja dedykowanych jednostek obliczeniowych, takich jak rdzenie Tensor (wyspecjalizowane procesory macierzowe zintegrowane w układzie graficznym, zoptymalizowane pod kątem operacji na macierzach liczbowych) oraz rdzenie CUDA (ogólne jednostki cieniujące wykonujące obliczenia równoległe). Istotne jest także wsparcie dla precyzji obliczeń o obniżonej dokładności, takich jak FP16 (16-bitowy format zmiennoprzecinkowy), BF16 (format Brain Floating Point o rozszerzonym zakresie dynamiki) oraz formatów całkowitoliczbowych INT8 i INT4, które umożliwiają uruchamianie skwantyzowanych modeli przy znacznie mniejszym zużyciu pamięci.
Zapotrzebowanie na moc obliczeniową oraz pamięć karty graficznej zależy wprost od rodzaju zadań realizowanych przez użytkownika. Poszczególne typy modeli różnią się strukturą obliczeń oraz sposobem alokacji zasobów sprzętowych.
W przypadku dużych modeli językowych LLM (wielkich modeli tekstowych, takich jak architektury Llama, Mistral, Qwen czy DeepSeek) głównym ograniczeniem jest pamięć VRAM oraz jej przepustowość. Podczas inferencji (procesu generowania odpowiedzi na podstawie zadanego promptu) model musi odczytać wszystkie swoje wagi dla każdego wygenerowanego tokenu. Im większy model pod względem liczby parametrów (wyrażanej w miliardach, np. 7B, 14B, 32B lub 70B), tym większej pamięci wymaga do załadowania.
W zastosowaniach związanych z generowaniem grafiki oraz wideo (narzędzia takie jak Stable Diffusion, Stable Video Diffusion, Flux czy środowisko ComfyUI) kluczowa jest nie tylko pamięć VRAM, ale także czysta moc obliczeniowa rdzeni Tensor. Generowanie obrazu wymaga wieloetapowego procesu odszumiania (przekształcania losowego szumu w czytelny obraz), co silnie obciąża jednostki wykonawcze GPU. Zbyt mała ilość pamięci uniemożliwia generowanie grafik w wysokiej rozdzielczości lub wymusza korzystanie z wolniejszych algorytmów kafelkowania obrazu.
W przypadku modeli rozpoznawania mowy i transkrypcji dźwięku (takich jak architektura Whisper) oraz modeli przetwarzania obrazu OCR (optycznego rozpoznawania znaków) wymagania pamięciowe są zazwyczaj umiarkowane. Modele te mogą efektywnie pracować na kartach o mniejszej pojemności pamięci wideo, o ile zapewniona jest odpowiednia optymalizacja środowiska wykonawczego.
Osobną kategorię stanowi douczanie modeli (fine-tuning) oraz tworzenie adapterów LoRA (Low-Rank Adaptation, technika efektywnego dopasowywania modelu do specyficznych danych przy niskim narzucie pamięciowym). Proces treningu wymaga znacznie więcej pamięci VRAM niż samo wnioskowanie, ponieważ oprócz wag modelu karta musi przechowywać gradienty, stany optymalizatora oraz dane wejściowe w partiach.
Kwantyzacja to proces matematycznej kompresji wag modelu sztucznej inteligencji, polegający na redukcji precyzji zapisu liczb z 16 bitów do 8, 5, 4 lub nawet mniejszej liczby bitów. Pozwala to na znaczne zmniejszenie rozmiaru pliku modelu i jego zapotrzebowania na pamięć VRAM przy zachowaniu większości pierwotnej jakości generowanych odpowiedzi.
Dostępne na rynku karty graficzne można podzielić na kilka progów użyteczności w zależności od dostępnej pamięci wideo:
Samodzielny zakup karty graficznej do zastosowań sztucznej inteligencji często wiąże się z kosztownymi pomyłkami wynikającymi z nieznajomości specyfiki działania bibliotek obliczeniowych oraz ograniczeń architektury komputera.
Częstym błędem jest kierowanie się wyłącznie rankingami wydajności w grach komputerowych. Karta graficzna zorientowana na gry może posiadać bardzo szybki rdzeń graficzny, ale zbyt wąską magistralę danych lub tylko 8 GB pamięci VRAM, co czyni ją nieużyteczną przy próbie załadowania bardziej rozbudowanego modelu językowego. W zastosowaniach AI większa pojemność pamięci VRAM na nieco wolniejszym układzie jest zazwyczaj bardziej wartościowa niż szybszy rdzeń ze zbyt małą pamięcią.
Drugim powszechnym problemem jest niedoszacowanie zapotrzebowania na moc zasilacza komputerowego (PSU, jednostka zasilająca komputer). Nowoczesne karty graficzne o wysokiej wydajności pobierają pod pełnym obciążeniem znaczną ilość energii elektrycznej, a także generują chwilowe skoki poboru mocy, które w przypadku zbyt słabego lub wyeksploatowanego zasilacza prowadzą do natychmiastowego wyłączenia komputera lub niestabilności systemu operacyjnego.
Trzecim błędem jest ignorowanie fizycznych gabarytów karty oraz wymagań dotyczących odprowadzania ciepła. Długotrwałe generowanie grafik lub przetwarzanie dużych partii tekstu obciąża kartę w pełnym stopniu przez wiele godzin. Karta zamontowana w zbyt ciasnej obudowie o słabym przepływie powietrza ulega zjawisku dławienia termicznego (thermal throttling, automatyczne obniżanie taktowania rdzenia w celu ochrony przed przegrzaniem), co drastycznie spowalnia pracę.
Czwartym błędem jest zakup układów graficznych producentów, którzy nie posiadają dojrzałego wsparcia w powszechnie stosowanych bibliotekach sztucznej inteligencji (takich jak PyTorch, TensorRT-LLM, llama.cpp, vLLM czy bitsandbytes). Choć otwarte standardy stopniowo się rozwijają, wiele wyspecjalizowanych repozytoriów kodu nadal optymalizowanych jest wyłącznie pod kątem ekosystemu CUDA, a uruchomienie ich na alternatywnych układach wymaga zaawansowanej wiedzy programistycznej lub bywa niemożliwe.
Sama karta graficzna nie działa w izolacji, a pełne wykorzystanie jej potencjału wymaga odpowiedniego zbalansowania całej platformy sprzętowej komputera stacjonarnego.
Pamięć operacyjna RAM komputera odgrywa istotną rolę podczas uruchamiania i przełączania modeli. Przed załadowaniem wag do pamięci karty graficznej model jest najpierw odczytywany z dysku do pamięci systemowej RAM. Bezpieczną zasadą przy budowie stacji do AI jest posiadanie co najmniej dwukrotnie większej pojemności pamięci RAM niż wynosi łączna pamięć VRAM zainstalowanych kart graficznych (np. minimum 64 GB pamięci RAM dla komputera z kartą o pojemności 24 GB VRAM).
Wymagana jest również wysoka przepustowość pamięci masowej. Pliki modeli sztucznej inteligencji mają rozmiary od kilku do kilkudziesięciu gigabajtów. Zastosowanie szybkiego dysku półprzewodnikowego SSD NVMe (Non-Volatile Memory Express, protokół pamięci masowej podłączany bezpośrednio do magistrali PCIe) skraca czas ładowania modelu do pamięci z kilkunastu minut do zaledwie kilku sekund.
Równie istotna jest konfiguracja płyty głównej oraz wersja magistrali PCIe (Peripheral Component Interconnect Express, złącze komunikacyjne karty rozszerzeń). Karta graficzna powinna pracować w gnieździe zapewniającym pełną liczbę linii transmisyjnych (PCIe x16) w standardzie co najmniej PCIe 4.0 lub PCIe 5.0. W przypadku konfiguracji z dwoma układami graficznymi kluczowe jest, aby płyta główna i procesor obsługiwały podział linii bez drastycznej degradacji przepustowości.
Zasilacz komputerowy musi posiadać odpowiednią moc znamionową z zachowaniem marginesu bezpieczeństwa (z reguły od 750W do 1200W w zależności od wybranego modelu karty) oraz natywne przewody zasilające o odpowiednim przekroju, w tym złącza standardu 12VHPWR (nowe 16-pinowe złącze zasilania kart graficznych wysokiej mocy) lub odpowiednią liczbę niezależnych wiązek 8-pin PCIe.
Podczas wdrażania lokalnego środowiska sztucznej inteligencji zdarzają się sytuacje, w których system działa wolno lub zwraca błędy, mimo że zainstalowana karta graficzna dysponuje odpowiednią mocą obliczeniową. Prawidłowa diagnoza pozwala wyeliminować problemy konfiguracyjne przed podejmowaniem decyzji o kolejnych zakupach sprzętowych.
Najczęstszą przyczyną jest częściowe odciążenie procesora GPU i przeniesienie części obliczeń na CPU. W programach takich jak Ollama, LM Studio czy Text Generation WebUI użytkownik ma możliwość zdefiniowania liczby warstw modelu przesyłanych do pamięci karty graficznej (parametr gpu-layers lub n_gpu_layers). Jeśli parametr ten jest ustawiony zbyt nisko lub pamięć VRAM ulegnie zapełnieniu, pozostałe warstwy są przetwarzane przez procesor główny komputera, co powoduje natychmiastowy spadek wydajności nawet o kilkadziesiąt razy.
Drugą przyczyną jest błąd przepełnienia pamięci OOM (Out Of Memory, błąd braku wolnej pamięci operacyjnej lub wideo) wywołany zbyt dużym rozmiarem okna kontekstu. Każdy token dodany do historii rozmowy generuje dodatkowe dane w buforze pamięci podręcznej kluczy i wartości (KV Cache). Zwiększenie okna kontekstu z 4000 do 32 000 tokenów może wymagać kilku dodatkowych gigabajtów pamięci VRAM, co przy braku odpowiedniej rezerwy powoduje awarię procesu generowania.
Trzecim czynnikiem są nieaktualne lub niekompatybilne wersje bibliotek obliczeniowych (np. brak zainstalowanego pakietu sterowników CUDA Toolkit lub brak aktywacji biblioteki FlashAttention, która optymalizuje zużycie pamięci i przyspiesza obliczenia uwagi w sieciach transformatorowych). W takich przypadkach odpowiednia rekonfiguracja oprogramowania pozwala uzyskać znaczący wzrost wydajności bez ingerencji w sprzęt.
Uruchomienie modelu językowego wyłącznie na procesorze głównym komputera jest technicznie możliwe dzięki bibliotekom programistycznym wykorzystującym instrukcje wektorowe procesora. Prędkość generowania tekstu na procesorze jest jednak wielokrotnie niższa niż na karcie graficznej z pamięcią VRAM. O ile dla krótkich testów na modelach o małej liczbie parametrów procesor może wystarczyć, o tyle regularna praca, generowanie grafiki czy obsługa długich dokumentów wymaga dedykowanego układu graficznego.
Zastosowanie dwóch kart graficznych (np. dwóch układów po 16 GB VRAM) pozwala na sumaryczne uzyskanie 32 GB pamięci, co umożliwia załadowanie bardzo dużych modeli w niższej cenie niż pojedyncza profesjonalna karta o dużej pojemności. Wymaga to jednak odpowiedniej płyty głównej z dwoma pełnowymiarowymi gniazdami PCIe, bardzo mocnego zasilacza oraz obudowy z wydajnym obiegiem powietrza. Jedna karta o pojemności 24 GB jest rozwiązaniem prostszym w montażu, zużywa mniej energii i generuje mniej problemów z chłodzeniem, jednak konfiguracje multi-GPU są opłacalną alternatywą przy braku budżetu na topowe układy jednordzeniowe.
Ekosystem oprogramowania do sztucznej inteligencji przez kilkanaście lat rozwijał się w oparciu o środowisko CUDA oraz biblioteki cuDNN (CUDA Deep Neural Network, zbiór zoptymalizowanych algorytmów głębokiego uczenia). Większość modeli open-source, frameworków badawczych i narzędzi uruchomieniowych powstaje w pierwszej kolejności z myślą o tej architekturze. Wybór karty opartej na tym standardzie zapewnia natychmiastową kompatybilność z nowo publikowanymi modelami i oprogramowaniem bez konieczności kompilowania kodu ze źródeł czy stosowania warstw translacji.
W przeważającej większości współczesnych laptopów układ graficzny oraz pamięć VRAM są na stałe przylutowane do płyty głównej (układ w obudowie BGA, Ball Grid Array), co wyklucza ich wymianę na mocniejszy model. Z tego względu modernizacja sprzętu przenośnego pod kątem AI sprowadza się do doboru i zakupu odpowiednio skonfigurowanego nowego laptopa lub zastosowania zewnętrznej stacji eGPU (External GPU, zewnętrzna karta graficzna w obudowie z własnym zasilaniem podłączana przez port Thunderbolt lub USB4), o ile konstrukcja laptopa obsługuje taki standard.
W przeciwieństwie do gier, gdzie obciążenie karty bywa zmienne, proces inferencji na dużym modelu językowym lub trenowanie adaptera LoRA utrzymuje pobór mocy na poziomie zbliżonym do maksymalnego limitu TDP (Thermal Design Power, maksymalna ilość ciepła wydzielana przez układ pod obciążeniem) przez cały czas trwania zadania. Karta pobierająca 300-450W oddaje tę energię w postaci ciepła do wnętrza obudowy. Niewystarczająca wentylacja prowadzi do przegrzewania sekcji zasilania płyty głównej oraz samej karty, co skraca żywotność komponentów i może prowadzić do niestabilności systemu.
Dobór właściwej karty graficznej do lokalnego przetwarzania sztucznej inteligencji wymaga uwzględnienia nie tylko parametrów samego procesora graficznego, ale także możliwości zasilacza, płyty głównej, procesora oraz obiegu powietrza w komputerze stacjonarnym. Precyzyjne dopasowanie sprzętu do planowanego typu modeli pozwala uniknąć niepotrzebnych wydatków na komponenty, których potencjał nie zostanie wykorzystany, oraz chroni przed zakupem podzespołów niespełniających minimalnych wymagań pamięciowych.
Usługa realizowana jest bezpośrednio w siedzibie firmy lub w domu klienta na terenie Warszawy oraz w promieniu do 40 kilometrów w okolicznych powiatach. Obejmuje ona kompleksową analizę planowanych zastosowań AI, weryfikację kompatybilności obecnej konfiguracji komputerowej, doradztwo w zakupie fabrycznie nowych podzespołów oraz ich profesjonalny montaż wraz z testami obciążeniowymi i temperaturowymi.