- Kierowca dostępny teraz
- całą dobę, 7 dni w tygodniu
- Dojazd do 1 h w promieniu 40 km
- Diagnoza laptopa 0 zł

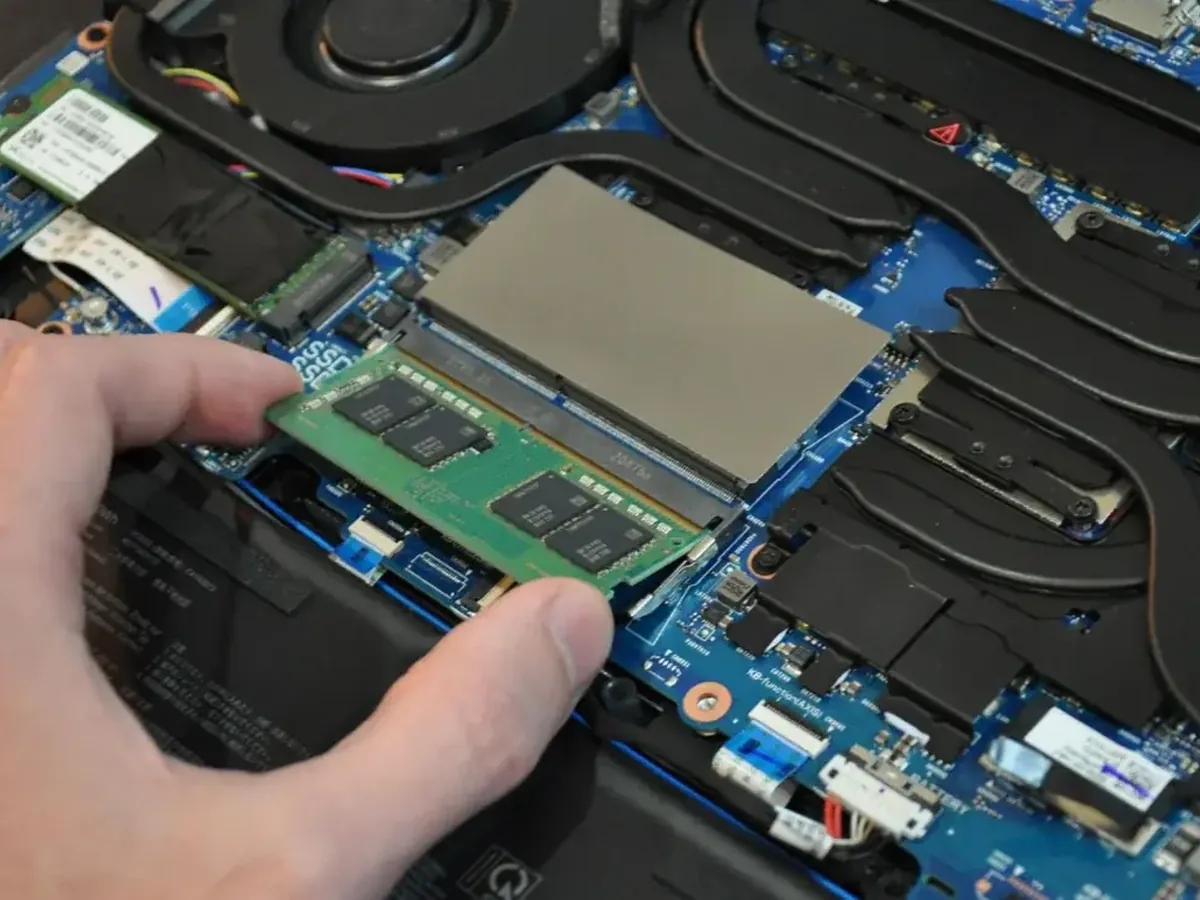
Jeśli ocena sprzętu wykaże, że obecny komputer nie wystarcza do sprawnej pracy z lokalnym modelem AI, kolejnym krokiem jest jego modernizacja — nie zawsze oznacza to konieczność zakupu zupełnie nowego sprzętu.
Zgłoszenia dotyczą firm, którym ocena sprzętowa wykazała niedobory w stosunku do wymagań wybranego modelu AI, a także firm, które próbowały uruchomić model na obecnym sprzęcie i doświadczyły zbyt wolnego działania.
Najczęstsze ograniczenia: zbyt mała ilość pamięci RAM w stosunku do wymagań modelu, brak karty graficznej z wystarczającą pamięcią VRAM przy większych modelach, oraz wolny dysk talerzowy zamiast SSD, spowalniający wczytywanie modelu przy każdym uruchomieniu.
Modernizacja dobierana jest indywidualnie do wymagań konkretnego modelu AI, jaki firma planuje wykorzystywać — nie zawsze potrzebna jest wymiana całego komputera, czasem wystarczy rozbudowa pamięci RAM albo przesiadka na dysk SSD lub NVMe. Przy modelach wymagających większej mocy obliczeniowej dobierana i montowana jest odpowiednia karta graficzna. Po modernizacji wykonywany jest test działania modelu na docelowym sprzęcie, żeby potwierdzić realną poprawę wydajności.
Modernizacja komputera to zwykle jeden do kilku dni pracy, zależnie od zakresu wymienianych podzespołów i ich dostępności.
Warto sprawdzić budżet przeznaczony na modernizację oraz określić priorytety — czasem lepszym wyborem jest inwestycja w kartę graficzną, a czasem w samą pamięć RAM, w zależności od wybranego modelu AI.
Czego nie robić: nie warto modernizować komputera „po trochu", dokupując pojedyncze podzespoły bez wcześniejszego planu — lepiej ustalić od razu docelową konfigurację i wdrożyć ją w jednym kroku.
Modernizacja wyceniana jest indywidualnie, zależnie od zakresu wymienianych podzespołów. Wykonane prace objęte są gwarancją do 12 miesięcy.
Dobór podzespołów zależy bezpośrednio od typu zadań, jakie mają być wykonywane lokalnie na stacji roboczej. Inne zasoby są potrzebne do przetwarzania tekstu, a inne do generowania grafiki czy analizy dźwięku.
W przypadku dużych modeli językowych (LLM, czyli Large Language Model — modele przetwarzające i generujące tekst) kluczowym czynnikiem jest ilość pamięci operacyjnej oraz jej przepustowość. Model o określonej liczbie parametrów musi zmieścić się w całości w pamięci podręcznej, aby generowanie odpowiedzi odbywało się płynnie. Jeśli cały model mieści się w pamięci VRAM (Video RAM — dedykowana, szybka pamięć karty graficznej), prędkość generowania tekstu jest najwyższa. W sytuacji, gdy pamięci graficznej brakuje, część modelu może zostać załadowana do głównej pamięci RAM (Random Access Memory — pamięć operacyjna komputera), co jednak obniża tempo generowania kolejnych tokenów (podstawowych jednostek tekstu, takich jak słowa lub ich fragmenty).
Przy modelach dyfuzyjnych (Diffusion Models — algorytmy służące do generowania oraz edycji grafiki na podstawie opisów tekstowych) zapotrzebowanie na moc obliczeniową karty graficznej jest jeszcze wyższe. Do sprawnego tworzenia obrazów o wysokiej rozdzielczości niezbędna jest karta wyposażona w rdzenie Tensor (wyspecjalizowane jednostki wykonawcze przyspieszające operacje na macierzach liczbowych) oraz odpowiedni zapas pamięci VRAM. Brak odpowiedniej ilości pamięci wideo uniemożliwia wygenerowanie obrazu o większych wymiarach lub powoduje błąd przepełnienia pamięci.
Przetwarzanie mowy na tekst (STT, czyli Speech-to-Text — automatyczna transkrypcja nagrań audio) oraz synteza mowy (TTS, czyli Text-to-Speech — odczytywanie tekstu głosem syntetycznym) mają zróżnicowane wymagania. Mniejsze modele transkrypcyjne mogą działać stabilnie na wielordzeniowym procesorze CPU (Central Processing Unit — główna jednostka obliczeniowa komputera), jednak przy pracy ciągłej lub analizie długich nagrań w czasie rzeczywistym wsparcie akceleratora graficznego znacznie skraca czas przetwarzania.
Osobną kategorią jest douczanie modeli (fine-tuning — proces dostosowywania istniejącego modelu do specyfiki danych firmowych) oraz budowa lokalnych baz wiedzy (RAG, czyli Retrieval-Augmented Generation — technologia wzbogacająca odpowiedzi sztucznej inteligencji o treść wewnętrznych dokumentów przedsiębiorstwa). Tego typu zadania wymagają równoległego dostępu do dużej pamięci RAM, szybkiego nośnika danych oraz wydajnego układu graficznego.
Modernizacja komputera pod kątem sztucznej inteligencji wymaga zrównoważenia wszystkich podzespołów, ponieważ najsłabszy element zestawu ogranicza wydajność całego systemu.
Karta graficzna stanowi główny motor obliczeniowy dla większości zadań sztucznej inteligencji. Przy jej wyborze najważniejsza jest pojemność pamięci VRAM oraz szerokość magistrali pamięci (wyrażana w bitach, określająca przepustowość przesyłu danych). Większa pojemność pozwala na załadowanie większych modeli lub zastosowanie mniejszej kompresji, co bezpośrednio przekłada się na jakość generowanych odpowiedzi i brak błędów pamięci.
Pamięć operacyjna RAM odpowiada za przechowywanie danych tymczasowych oraz modeli w przypadku pracy na procesorze lub przy podziale wag pomiędzy procesor a kartę graficzną. Istotna jest nie tylko łączna pojemność, ale także konfiguracja wielokanałowa (Dual Channel lub Quad Channel — technologia pozwalająca na równoległą komunikację z kilkoma modułami pamięci jednocześnie). Zastosowanie szybszych modułów pamięci o niskich opóźnieniach pozwala zauważalnie przyspieszyć pracę modeli działających częściowo lub całkowicie poza kartą graficzną.
Dysk SSD NVMe (Non-Volatile Memory Express — standard komunikacji półprzewodnikowych nośników danych podłączanych bezpośrednio do magistrali płyty głównej) decyduje o czasie uruchamiania środowiska i wczytywania modeli. Pliki wag nowoczesnych modeli mają rozmiary od kilku do kilkudziesięciu gigabajtów. Szybki nośnik NVMe skraca czas załadunku modelu z kilkudziesięciu sekund do kilku sekund, a także zapobiega zacięciom podczas ładowania dokumentów do bazy wektorowej.
Zasilacz komputerowy (PSU, czyli Power Supply Unit — moduł dostarczający stabilne napięcie do wszystkich komponentów) musi posiadać odpowiedni zapas mocy oraz certyfikat sprawności. Obliczenia sztucznej inteligencji potrafią obciążać procesor i kartę graficzną w pełnym zakresie przez wiele godzin. Zbyt słaby zasilacz lub brak odpowiednich dedykowanych przewodów zasilających może powodować nagłe wyłączanie się komputera lub niestabilność systemu podczas pracy.
Układ chłodzenia i obudowa komputera odpowiadają za odprowadzanie dużych ilości ciepła generowanych podczas długotrwałych obliczeń. W przypadku niedostatecznej wentylacji podzespoły wchodzą w stan throttlingu termicznego (automatyczne obniżanie taktowania zegarów procesora lub karty graficznej w celu ochrony przed przegrzaniem), co drastycznie obniża wydajność generowania odpowiedzi.
Płyta główna oraz magistrala PCIe (Peripheral Component Interconnect Express — złącze komunikacyjne do montażu kart rozszerzeń) muszą zapewniać odpowiednią przepustowość. Istotna jest wersja standardu PCIe oraz liczba przypisanych linii sygnałowych, szczególnie gdy w komputerze planowany jest montaż więcej niż jednej karty rozszerzeń.
Samodzielna wymiana podzespołów bez uwzględnienia specyfiki obliczeń sztucznej inteligencji często prowadzi do nieoptymalnego wydatkowania środków lub problemów technicznych.
Częstym błędem jest dobieranie karty graficznej na podstawie ogólnej wydajności w grach komputerowych, z pominięciem ilości pamięci VRAM. Nowoczesna karta o wysokim taktowaniu rdzenia, lecz wyposażona w niewielką ilość pamięci wideo, nie pozwoli na uruchomienie bardziej zaawansowanych modeli językowych, podczas gdy karta z większą ilością pamięci VRAM poradzi sobie z tym zadaniem bez problemu.
Innym problemem jest dokupowanie pojedynczych modułów pamięci RAM o innych parametrach taktowania i opóźnień niż moduły już zainstalowane w komputerze. Może to prowadzić do wymuszenia pracy całej pamięci z najniższą wspólną częstotliwością lub całkowitego wyłączenia trybu dwukanałowego (Dual Channel), co drastycznie ogranicza przepustowość przesyłu danych pomiędzy pamięcią a procesorem.
Zdarza się również montaż wydajnej karty graficznej w małej obudowie biurowej o zablokowanym przepływie powietrza lub przy użyciu fabrycznego, zbyt słabego zasilacza. Prowadzi to do przegrzewania się sekcji zasilania płyty głównej, głośnej pracy wentylatorów oraz niespodziewanych restartów systemu w trakcie przetwarzania zapytań.
Nierzadko spotykanym błędem jest także pozostawienie bazy danych i plików modeli na starym dysku mechanicznym HDD (Hard Disk Drive — tradycyjny dysk talerzowy z ruchomą głowicą) lub wolnym dysku SSD podłączonym przez starsze złącze SATA. Powoduje to bardzo długie oczekiwanie na gotowość modelu do pracy po każdym uruchomieniu aplikacji.
Przed podjęciem decyzji o wymianie podzespołów konieczna jest weryfikacja, czy obecny sprzęt jest poprawnie wykorzystywany przez zainstalowane oprogramowanie.
Częstą przyczyną wolnego działania jest brak aktywacji akceleracji sprzętowej w środowisku wykonawczym (np. biblioteki CUDA — platformy obliczeń równoległych dla kart graficznych). Jeśli aplikacja wykonuje obliczenia wyłącznie na procesorze CPU zamiast przekazywać je do karty graficznej, model działa wielokrotnie wolniej, mimo że w komputerze zainstalowany jest odpowiedni układ graficzny.
Kolejną kwestią jest dobór formatu i poziomu kwantyzacji (proces zmniejszania precyzji zapisu wag modelu, np. z 16-bitowej do 4-bitowej lub 8-bitowej, co zmniejsza zapotrzebowanie na pamięć przy zachowaniu wysokiej jakości odpowiedzi). Próba uruchomienia modelu w pełnej precyzji bez kwantyzacji na standardowym komputerze prowadzi do natychmiastowego wyczerpania pamięci VRAM i zrzucenia danych do powolnej pamięci wirtualnej na dysku.
Niewłaściwa konfiguracja parametru GPU offloading (określającego liczbę warstw sieci neuronowej przesyłanych do pamięci karty graficznej) może powodować, że pamięć karty pozostaje w połowie pusta, a reszta obliczeń niepotrzebnie obciąża procesor. Poprawne dostrojenie parametrów silnika wykonawczego pozwala w wielu przypadkach uzyskać płynną pracę bez konieczności natychmiastowych zakupów.
Nie jest to bezwzględnie wymagane w przypadku mniejszych modeli językowych, które można uruchomić na samym procesorze CPU przy odpowiedniej ilości szybkiej pamięci RAM. Jednak dedykowana karta graficzna z pamięcią VRAM zapewnia wielokrotnie wyższe tempo generowania odpowiedzi, co jest kluczowe przy codziennej pracy wielu osób w firmie lub przy zadaniach graficznych.
Pamięć RAM (Random Access Memory) to główna pamięć operacyjna systemu, charakteryzująca się dużą pojemnością, lecz niższą przepustowością przesyłu danych. Pamięć VRAM (Video RAM) znajduje się bezpośrednio na karcie graficznej i oferuje wielokrotnie szybszą wymianę informacji z procesorem graficznym GPU, co pozwala na błyskawiczne wykonywanie operacji macierzowych niezbędnych w sztucznej inteligencji.
Jest to możliwe, pod warunkiem że płyta główna posiada odpowiednią liczbę wolnych gniazd PCIe, zasilacz dysponuje wystarczającą mocą i odpowiednimi złączami, a obudowa zapewnia swobodny przepływ powietrza. Dwie karty graficzne pozwalają na sumowanie dostępnej pamięci VRAM w niektórych silnikach obliczeniowych, co umożliwia uruchamianie znacznie większych modeli.
W przypadku stacji roboczej obsługującej lokalną bazę wiedzy i model językowy zalecane minimum to 32 GB pamięci RAM, natomiast dla bardziej rozbudowanych zastosowań z równoległym przetwarzaniem wielu dokumentów optymalna konfiguracja wynosi 64 GB lub 128 GB pamięci działającej w trybie wielokanałowym.
Serwisant dojeżdża bezpośrednio do siedziby firmy, gdzie przeprowadza diagnostykę obecnej konfiguracji sprzętowej oraz weryfikuje zapotrzebowanie planowanych narzędzi sztucznej inteligencji. Następnie montowane są dobrane komponenty, sprawdzana jest stabilność zasilania oraz chłodzenia, a na koniec przeprowadzane są testy wydajnościowe na docelowym modelu AI.
Prawidłowo zaplanowana modernizacja pozwala przekształcić standardowy komputer biurowy lub stację roboczą w wydajne środowisko do pracy z lokalną sztuczną inteligencją, zachowując pełną kontrolę nad danymi firmowymi bez konieczności inwestowania w całkowicie nowy zestaw komputerowy. Wszystkie czynności związane z oceną podzespołów, montażem pamięci RAM, dysków SSD NVMe, kart graficznych oraz zasilaczy wykonujemy bezpośrednio w siedzibie klienta na terenie Warszawy i okolicznych miejscowości. Po zakończeniu prac montażowych przeprowadzamy pełne testy obciążeniowe i weryfikację poprawności działania silnika obliczeniowego, co zapewnia stabilną i bezawaryjną pracę systemu.