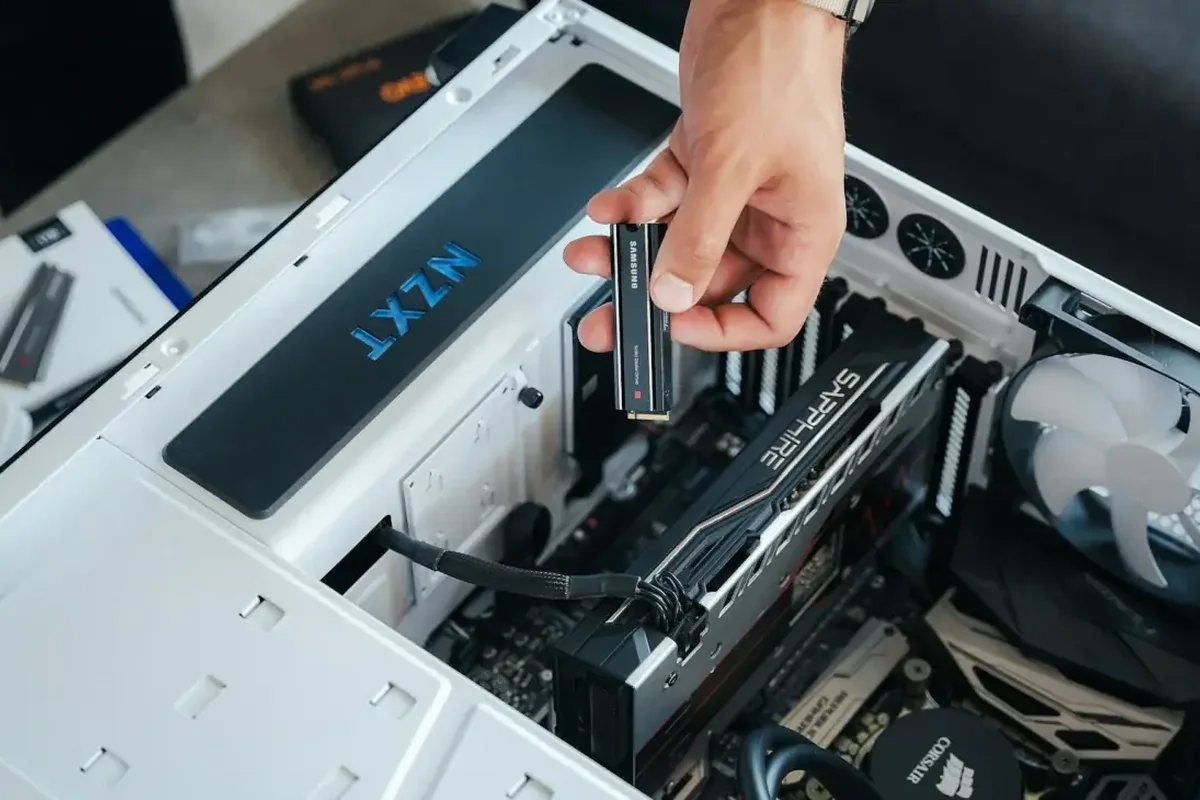
Lokalny model językowy działa bezpośrednio na komputerze firmowym, bez przesyłania zapytań na zewnętrzne serwery — dla części firm to kluczowy argument przy wyborze między AI chmurowym a lokalnym.
Na czym polega ta usługa
Usługa obejmuje dobór modelu językowego odpowiedniego do możliwości sprzętowych komputera i potrzeb firmy, jego instalację oraz podstawową konfigurację umożliwiającą wygodną codzienną pracę.
Dla kogo ma sens
Usługa jest przydatna dla firm, którym zależy na pracy z modelem językowym bez przesyłania zapytań poza infrastrukturę firmową.
Ile to trwa
Instalacja lokalnego modelu językowego mieści się z reguły w standardowym czasie do 3 dni, w zależności od wybranego modelu i sprzętu.
Warunki
Diagnoza wstępna i wycena są bezpłatne. Dojazd na terenie Warszawy i okolic jest bezpłatny, a usługa objęta jest gwarancją do 12 miesięcy.
Dlaczego firmy decydują się na lokalne modele językowe
Wykorzystanie sztucznej inteligencji bezpośrednio na firmowym sprzęcie komputerowym pozwala na zachowanie całkowitej kontroli nad przetwarzanymi informacjami. W przypadku korzystania z publicznych usług chmurowych każde zapytanie wpisane przez pracownika trafia na zewnętrzne serwery operatora usługi, co w wielu branżach wiąże się z ryzykiem naruszenia tajemnicy przedsiębiorstwa, przepisów o ochronie danych osobowych (RODO) lub wewnętrznych regulacji dotyczących bezpieczeństwa teleinformatycznego.
Lokalny model językowy (LLM, czyli Large Language Model – zaawansowany program komputerowy przetwarzający język naturalny) działa w całości w pamięci i na procesorach stacji roboczej lub serwera znajdującego się w biurze. Wszystkie dokumenty, bazy wiedzy, kody źródłowe oraz wpisywane prompty (polecenia tekstowe kierowane do modelu) pozostają w zamkniętej sieci lokalnej (LAN). Dodatkowo, wdrożenie lokalnego rozwiązania uniezależnia codzienne procesy od stabilności łącza internetowego, awarii zewnętrznych platform oraz opłat subskrypcyjnych naliczanych za liczbę przetworzonych tokenów (podstawowych jednostek tekstu, odpowiadających częściom słów).
Przed rozpoczęciem prac konfiguracyjnych na komputerze firmowym oferujemy podpisanie bezpłatnej umowy o zachowaniu poufności (NDA), co formalnie zabezpiecza wszystkie wrażliwe dane biznesowe przetwarzane w środowisku klienta.
Wymagania sprzętowe i architektura rozwiązań lokalnych
Efektywne działanie lokalnego modelu sztucznej inteligencji zależy od odpowiedniego dopasowania architektury oprogramowania do parametrów fizycznych podzespołów komputera. Kluczowe znaczenie mają następujące elementy stacji roboczej lub serwera:
- Pamięć wideo karty graficznej (VRAM): Pamięć VRAM (Video Random Access Memory – dedykowana pamięć podręczna karty graficznej) odpowiada za przechowywanie wag modelu oraz bufora kontekstu (KV cache). Im większa pojemność VRAM, tym większy model można załadować bez straty prędkości generowania tekstu. Karty graficzne z architekturą Nvidia oraz obsługą środowiska CUDA (technologia umożliwiająca wykorzystanie procesora graficznego do obliczeń ogólnych) zapewniają najwyższą wydajność w przetwarzaniu zapytań.
- Pamięć operacyjna (RAM) i procesor (CPU): W sytuacji, gdy pamięć karty graficznej jest zbyt mała, możliwe jest zastosowanie mechanizmu podziału warstw (CPU offloading), w którym część obliczeń przejmuje procesor główny i pamięć RAM. Wymaga to jednak zastosowania pamięci o wysokiej przepustowości (DDR4 lub DDR5 w trybie wielokanałowym), aby uniknąć spowolnienia pracy systemu.
- Kwantyzacja modeli (zmniejszanie precyzji zapisu wag): Aby umożliwić uruchamianie zaawansowanych modeli na standardowych komputerach biurowych, stosuje się formaty skwantowane (np. GGUF, AWQ lub EXL2). Proces ten polega na kompresji wag matematycznych z precyzji 16-bitowej (FP16) do formatu 4-bitowego lub 8-bitowego przy zachowaniu wysokiej precyzji językowej. Pozwala to na trzykrotne lub czterokrotne zmniejszenie zapotrzebowania na pamięć.
- Szybki dysk półprzewodnikowy SSD NVMe: Modele językowe zajmują od kilku do kilkudziesięciu gigabajtów przestrzeni dyskowej. Zastosowanie dysku SSD NVMe (nośnika pamięci podłączonego bezpośrednio do magistrali PCIe) skraca czas ładowania modelu do pamięci z kilkudziesięciu sekund do kilku sekund przy starcie usługi.
- System operacyjny: Konfigurujemy środowiska zarówno na stacjach roboczych z systemem Windows 10 i Windows 11, jak i na serwerach z dystrybucjami Linux (np. Ubuntu, Debian, Rocky Linux), zapewniając pełną zgodność ze środowiskiem sieciowym firmy.
Środowiska uruchomieniowe i interfejsy dla pracowników
Aby praca z lokalnym modelem była intuicyjna dla każdego członka zespołu, instalacja obejmuje nie tylko sam silnik obliczeniowy, ale także wygodny interfejs graficzny dostępny z poziomu przeglądarki internetowej.
W zależności od profilu działalności oraz specyfiki komputerów stosujemy sprawdzone środowiska wykonawcze (tzw. silniki inferencyjne – programy odpowiedzialne za bezpośrednie wykonywanie obliczeń macierzowych modelu):
- Ollama: Lekki i stabilny silnik do zarządzania modelami językowymi, który automatycznie wykrywa dostępną pamięć VRAM i zarządza alokacją zasobów sprzętowych. Umożliwia łatwą aktualizację i pobieranie najnowszych otwartych modeli językowych.
- vLLM oraz llama.cpp: Zoptymalizowane środowiska dla stacji roboczych i serwerów wymagających wysokiej przepustowości przy obsłudze wielu jednoczesnych zapytań od pracowników.
- Open WebUI: Nowoczesny interfejs graficzny uruchamiany w przeglądarce, wizualnie zbliżony do popularnych komercyjnych czatów internetowych. Umożliwia tworzenie osobnych kont dla pracowników, zarządzanie historią rozmów, przełączanie między różnymi modelami oraz tworzenie spersonalizowanych asystentów z własnymi instrukcjami systemowymi.
- Mechanizm RAG (Retrieval-Augmented Generation – generowanie wspomagane wyszukiwaniem wiedzy): Konfiguracja umożliwiająca pracownikom przeciąganie plików PDF, arkuszy kalkulacyjnych czy dokumentów tekstowych bezpośrednio do okna czatu. Model analizuje treść dokumentów lokalnie i odpowiada na pytania dotyczące konkretnych procedur, cenników czy umów bez przekazywania plików do sieci zewnętrznej.
- Lokalne API: Wystawienie punktu końcowego API (interfejsu programistycznego zgodnego ze standardem REST) w sieci firmowej, co pozwala programistom lub administratorom na integrowanie lokalnego modelu z systemami CRM, ERP, skryptami automatyzacji biurowej czy bazami danych.
Błędy przy samodzielnych próbach instalacji lokalnego AI
Samodzielne próby wdrożenia modeli językowych na komputerach biurowych często kończą się niepowodzeniem lub niską stabilnością całego systemu. Do najczęściej spotykanych problemów należą:
- Wybór modelu o parametrach przewyższających zasoby sprzętowe: Próba załadowania modelu o wielkości 70B (70 miliardów parametrów) na komputerze wyposażonym w 8 GB pamięci VRAM prowadzi do całkowitego zapełnienia pamięci wideo, zrzucania danych do pliku wymiany na dysku i spadku prędkości generowania tekstu poniżej jednego znaku na sekundę, co uniemożliwia normalną pracę.
- Brak właściwych sterowników i bibliotek obliczeniowych: Uruchomienie oprogramowania bez poprawnie skonfigurowanych sterowników graficznych, pakietu CUDA Toolkit oraz bibliotek cuDNN powoduje, że model wykonuje obliczenia wyłącznie na procesorze głównym (CPU), co wielokrotnie obniża jego wydajność i powoduje nadmierne nagrzewanie podzespołów.
- Błędne zarządzanie rozmiarem okna kontekstu: Okno kontekstu określa ilość tekstu, jaką model pamięta w trakcie bieżącej rozmowy. Ustawienie zbyt dużego kontekstu bez uwzględnienia narzutu pamięciowego (KV cache) powoduje błędy braku pamięci (CUDA Out of Memory) i nagłe wyłączanie się programu w trakcie dłuższej konwersacji.
- Brak zabezpieczeń w sieci lokalnej: Uruchomienie serwera modelu z domyślnymi ustawieniami sieciowymi bez uwierzytelniania może umożliwić nieautoryzowany dostęp do zasobów stacji roboczej innym urządzeniom znajdującym się w tej samej sieci firmowej.
- Brak konfiguracji usług systemowych: Uruchamianie silnika z poziomu otwartego okna terminala sprawia, że każde przypadkowe zamknięcie okna lub wylogowanie użytkownika przerywa działanie narzędzia dla pozostałych pracowników. Prawidłowa konfiguracja wymaga utworzenia usługi systemowej (Windows Service lub systemd na Linuksie), która uruchamia się automatycznie ze startem komputera.
Przykłady zastosowań w firmach
Lokalne modele językowe znajdują zastosowanie w wielu działach przedsiębiorstw, wspierając codzienną pracę bez generowania kosztów zewnętrznych licencji:
- Działy prawne i kadrowe: Analiza wielostronicowych umów, weryfikacja zgodności regulaminów wewnętrznych, przygotowywanie szablonów pism oraz anonimizacja dokumentów zawierających dane osobowe.
- Działy handlowe i obsługa klienta: Redagowanie spersonalizowanych odpowiedzi na zapytania ofertowe, tworzenie konspektów spotkań oraz tłumaczenie korespondencji z kontrahentami zagranicznymi.
- Działy techniczne i IT: Generowanie i analiza skryptów (np. PowerShell, Bash, Python), tworzenie dokumentacji technicznej kodu, automatyczne formatowanie danych z plików logów oraz wsparcie w diagnostyce problemów sieciowych.
- Zarząd i analitycy: Streszczanie raportów rynkowych, porządkowanie notatek ze spotkań oraz przygotowywanie zestawień informacji z rozproszonych plików tekstowych.
Często zadawane pytania (FAQ)
Czy lokalny model językowy wymaga stałego połączenia z internetem?
Nie. Po zakończeniu procesu instalacji, pobraniu wag modelu oraz skonfigurowaniu środowiska cały system działa w pełni offline. Komputer może zostać fizycznie odłączony od sieci internetowej, a model nadal będzie przetwarzał zapytania i analizował dokumenty z pełną wydajnością.
Jaka jest różnica w jakości odpowiedzi między modelem lokalnym a komercyjnym modelem w chmurze?
Nowoczesne otwarte modele językowe o optymalnej wielkości (od 7B do 14B parametrów) oferują bardzo wysoką sprawność w zadaniach biurowych, redagowaniu pism, tłumaczeniach oraz analizie dokumentów. Chociaż największe modele chmurowe posiadają szerszą wiedzę ogólną ze względu na biliony parametrów, właściwie dobrany i sparametryzowany model lokalny w zupełności wystarcza do większości codziennych zastosowań firmowych, zapewniając przy tym bezwzględną poufność.
Czy model można uruchomić na komputerze bez dedykowanej karty graficznej?
Tak, mniejsze modele językowe o wysokim stopniu kwantyzacji mogą działać na nowoczesnych wielordzeniowych procesorach z odpowiednią ilością pamięci RAM (minimum 16 GB lub 32 GB). Prędkość generowania tekstu będzie wówczas niższa niż na karcie graficznej z pamięcią VRAM, lecz wciąż w pełni wystarczająca do czytania i redagowania dokumentów.
Czy z jednego komputera z modelem może korzystać wielu pracowników w biurze?
Tak. Podczas konfiguracji instalujemy interfejs webowy, który można udostępnić w lokalnej sieci firmowej (LAN). Pracownicy logują się na własne konta przez przeglądarkę ze swoich komputerów biurowych lub laptopów, wysyłając zapytania do centralnej stacji roboczej realizującej obliczenia.
Czy wdrożenie obejmuje przeszkolenie pracowników?
Tak, po zakończeniu prac instalacyjnych serwisant prezentuje działanie systemu, wyjaśnia zasady prawidłowego formułowania zapytań (prompt engineering), pokazuje sposób wgrywania dokumentów do bazy wiedzy oraz omawia podstawowe zasady zarządzania pamięcią kontekstu.
Jak przebiega wizyta serwisanta i wdrożenie na miejscu
Usługę realizujemy z bezpośrednim dojazdem do siedziby firmy lub biura na terenie Warszawy oraz w promieniu do 40 kilometrów w okolicznych powiatach. W ramach wizyty wykonujemy pełny cykl wdrożeniowy:
- Audyt sprzętowy: Sprawdzamy konfigurację stacji roboczej lub serwera, w tym model procesora, pojemność pamięci RAM, parametry karty graficznej oraz dostępną przestrzeń na dyskach SSD.
- Instalacja i optymalizacja: Instalujemy dedykowane sterowniki, środowisko obliczeniowe (np. Ollama lub llama.cpp) oraz dobieramy model językowy optymalny pod kątem dostępnej pamięci i profilu działalności firmy.
- Konfiguracja interfejsu i sieci: Wdrażamy panel graficzny Open WebUI, konfigurujemy konta użytkowników, zabezpieczenia sieciowe oraz integrację z lokalną bazą wiedzy (RAG).
- Testy stabilności i wydajności: Przeprowadzamy testy obciążeniowe, weryfikując szybkość generowania tokenów, temperaturę podzespołów oraz stabilność zasilania pod pełnym obciążeniem.
Większość konfiguracji i wdrożeń realizujemy podczas jednej wizyty serwisowej. W przypadku modernizacji stacji roboczej lub konieczności rozbudowy pamięci RAM i wymiany dysku, zapewniamy bezpłatne wsparcie techniczne po wykonaniu usługi do 30 dni oraz gwarancję na wykonane prace do 12 miesięcy.
Bezpieczne wdrożenie sztucznej inteligencji dopasowane do Twojego sprzętu
Prawidłowe wdrożenie lokalnego modelu językowego pozwala połączyć zalety zaawansowanej automatyzacji tekstu z rygorystycznymi standardami ochrony danych w przedsiębiorstwie. Odpowiedni dobór kwantyzacji, optymalizacja bibliotek graficznych oraz konfiguracja intuicyjnego panelu przeglądarkowego sprawiają, że stacja robocza staje się autonomicznym centrum przetwarzania wiedzy firmowej bez generowania ukrytych kosztów zewnętrznych licencji.
Powiązane teksty