- Kierowca dostępny teraz
- całą dobę, 7 dni w tygodniu
- Dojazd do 1 h w promieniu 40 km
- Diagnoza laptopa 0 zł

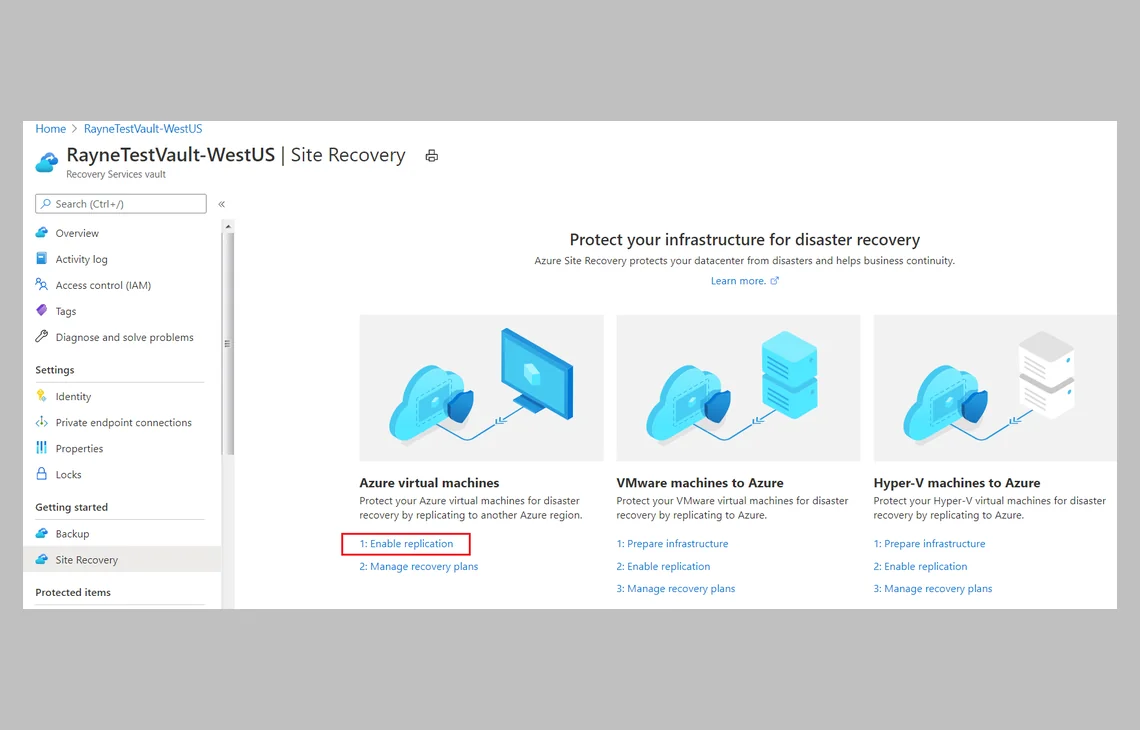
Plan ciągłości działania to odpowiedź na pytanie „co dokładnie robimy, gdy padnie serwer, zaleje serwerownię albo firma padnie ofiarą ataku ransomware" — spisana z wyprzedzeniem, zamiast improwizowana w panice.
Przygotowanie planu obejmuje analizę, które systemy są krytyczne dla działania firmy, ustalenie akceptowalnego czasu przestoju dla każdego z nich, skonfigurowanie odpowiednich kopii zapasowych i procedur przywracania, oraz spisanie kroków, które trzeba wykonać w kolejności podczas rzeczywistej awarii.
Plan ciągłości działania ma szczególne znaczenie dla firm, dla których nawet kilkugodzinny przestój oznacza realne straty finansowe lub utratę zaufania klientów — sklepów internetowych, firm usługowych z systemami rezerwacji, przedsiębiorstw produkcyjnych.
Przygotowanie planu mieści się z reguły w standardowym czasie do 3 dni, w zależności od złożoności infrastruktury firmy.
Diagnoza wstępna i wycena są bezpłatne. Dojazd na terenie Warszawy i okolic jest bezpłatny, a usługa objęta jest gwarancją do 12 miesięcy.
Plan ciągłości działania to nie pojedynczy dokument „na półkę", lecz zestaw powiązanych ze sobą procedur i konfiguracji. Gotowe opracowanie obejmuje kilka elementów, które razem tworzą spójny łańcuch reakcji na awarię.
Pierwszym z nich jest inwentaryzacja zasobów IT — lista serwerów, stacji roboczych, urządzeń sieciowych, systemów operacyjnych i oprogramowania biznesowego, z zaznaczeniem wzajemnych zależności. Jeśli firma korzysta na przykład z Subiekta nexo, który łączy się z bazą SQL Server na osobnym serwerze, plan musi uwzględniać kolejność uruchamiania tych komponentów — najpierw serwer bazy danych, potem aplikacja, potem stanowiska klienckie.
Drugim elementem jest klasyfikacja priorytetów, czyli podział systemów na kategorie według tego, jak szybko muszą wrócić do działania. System fakturowania lub magazynu (np. WF-Mag, Comarch ERP Optima, WAPRO Mag) ma zwykle wyższy priorytet niż wewnętrzny serwer plików z archiwalnymi dokumentami. Każda kategoria otrzymuje dwa parametry: RTO (Recovery Time Objective — maksymalny dopuszczalny czas przestoju) i RPO (Recovery Point Objective — maksymalny dopuszczalny okres utraty danych, np. „dane nie starsze niż ostatnie 4 godziny").
Trzecim elementem jest opis procedur przywracania — krok po kroku, napisany w sposób zrozumiały dla osoby, która niekoniecznie konfigurowała te systemy. Procedura zawiera: skąd pobrać kopię zapasową, jak uruchomić środowisko zastępcze, jakie dane logowania są potrzebne (przechowywane w zabezpieczonym, osobnym miejscu) i jak zweryfikować, że przywrócony system działa poprawnie.
Nie każda awaria wygląda tak samo, dlatego dobrze przygotowany plan obejmuje kilka typowych scenariuszy, różniących się skalą i wymaganą reakcją.
Awaria pojedynczego serwera — najczęstszy przypadek. Uszkodzony dysk, zawieszony system operacyjny lub problem z zasilaczem powoduje niedostępność jednego systemu. Plan określa, czy przywracanie odbywa się na tym samym sprzęcie (po wymianie uszkodzonego podzespołu), czy na zapasowej maszynie, i skąd brana jest kopia zapasowa.
Atak ransomware (oprogramowanie szyfrujące dane w celu wymuszenia okupu) — wymaga innego podejścia niż zwykła awaria sprzętowa. Kluczowe jest odcięcie zainfekowanych maszyn od sieci, ustalenie, które kopie zapasowe nie zostały zaszyfrowane, i przywrócenie danych z czystej kopii. Plan określa, kto podejmuje decyzję o odłączeniu sieci i w jakim momencie.
Awaria fizyczna lokalizacji — zalanie, pożar, długotrwała przerwa w dostawie prądu. W tym scenariuszu nie wystarczy kopia zapasowa przechowywana na dysku w tej samej serwerowni. Plan wskazuje lokalizację kopii zewnętrznych — np. w chmurze (Microsoft Azure, Google Workspace) lub na nośniku przechowywanym w innym budynku — oraz procedurę uruchomienia środowiska zastępczego.
Utrata dostępu do usług chmurowych — zablokowane konto administratora, wygasła subskrypcja, awaria dostawcy. Plan zawiera dane kontaktowe do wsparcia technicznego dostawcy, listę uprawnionych osób oraz procedurę odzyskiwania dostępu.
Wiele firm próbuje stworzyć plan ciągłości działania samodzielnie, korzystając z szablonów dostępnych w internecie. To lepsze niż brak jakiegokolwiek planu, ale w praktyce takie dokumenty często zawierają luki, które ujawniają się dopiero podczas rzeczywistej awarii.
Najczęstszy błąd to plan, który istnieje wyłącznie na papierze — kopie zapasowe są opisane, ale nikt nie sprawdził, czy faktycznie da się z nich przywrócić dane. Zdarza się, że backup (kopia zapasowa) wykonuje się automatycznie co noc, ale od miesięcy zapisuje uszkodzone lub niekompletne pliki, ponieważ nikt nie monitoruje logów zadania kopiowania.
Drugi częsty problem to brak aktualizacji planu po zmianach w infrastrukturze. Firma wdrożyła nowy system ERP (np. enova365 zamiast starego Rachmistrza GT), zmieniła strukturę sieci albo przeniosła część usług do chmury — ale plan ciągłości nadal opisuje poprzedni stan. Podczas awarii okazuje się, że procedury odnoszą się do serwera, który już nie istnieje.
Trzeci błąd to przechowywanie planu wyłącznie w formie elektronicznej na tym samym serwerze, którego dotyczy. Jeśli ten serwer jest niedostępny — plan również. Dlatego gotowy dokument powinien istnieć w co najmniej dwóch kopiach: jednej cyfrowej poza główną infrastrukturą i jednej wydrukowanej, dostępnej dla wyznaczonych osób.
Czwarty problem dotyczy haseł i danych dostępowych. Plan zakłada, że administrator „wie, jak się zalogować", ale gdy administrator jest niedostępny (urlop, choroba, zmiana pracy), nikt inny nie ma potrzebnych danych. Dobrze przygotowany plan zawiera zabezpieczoną listę kont i haseł odzyskiwania — przechowywaną osobno od samego planu, w zamkniętej kopercie lub w dedykowanym menedżerze haseł z dostępem dla więcej niż jednej osoby.
Plan, którego nikt nie przetestował, ma wartość orientacyjną — pozwala lepiej zrozumieć własną infrastrukturę, ale nie daje pewności, że zadziała w kryzysie. Testowanie polega na symulowanym przywróceniu danych z kopii zapasowej i sprawdzeniu, czy systemy uruchamiają się poprawnie, czy bazy danych są spójne i czy użytkownicy mogą normalnie pracować.
Test nie wymaga wyłączania produkcyjnych systemów. Przywrócenie odbywa się na osobnej maszynie lub w środowisku wirtualnym, bez wpływu na bieżącą pracę firmy. Serwisant przeprowadza taki test na miejscu u klienta, dokumentuje wynik i — jeśli coś nie zadziałało — koryguje procedury w planie.
Testowanie warto powtarzać co najmniej raz na pół roku lub po każdej istotnej zmianie w infrastrukturze: dodaniu nowego serwera, migracji na inny system ERP, zmianie dostawcy usług chmurowych.
Serwisant dojeżdża do siedziby firmy, przeprowadza audyt (przegląd) infrastruktury IT — sprawdza konfigurację serwerów, sposób wykonywania kopii zapasowych, topologię sieci (sposób połączenia urządzeń) i listę używanego oprogramowania. Na podstawie zebranych informacji przygotowuje plan dopasowany do konkretnego środowiska, nie do ogólnych założeń z szablonu.
Gotowy dokument jest omawiany z osobą odpowiedzialną za IT w firmie. Jeśli w organizacji nie ma wyznaczonego informatyka — plan jest pisany w sposób zrozumiały dla właściciela lub osoby zarządzającej, z objaśnieniem terminów technicznych.
Po wdrożeniu planu możliwe jest podpisanie NDA (umowy o zachowaniu poufności) — bezpłatnie, na życzenie. Dotyczy to zwłaszcza firm, których plan zawiera informacje o strukturze sieci, kontach czy systemach bezpieczeństwa.
Plan może obejmować dowolne urządzenia, których utrata lub awaria wpływa na pracę firmy. Jeśli pracownicy przechowują na laptopach lokalne kopie dokumentów, bazy danych czy konfiguracje VPN (szyfrowanego połączenia zdalnego) — plan powinien uwzględniać, jak te dane są zabezpieczane i jak szybko można uruchomić zastępczą stację roboczą. W przypadku laptopów na czas naprawy udostępniany jest bezpłatny laptop zastępczy z systemem Windows, bez kaucji i bez limitu czasowego.
Kopia zapasowa to jeden z elementów planu, ale nie cały plan. Dysk zewnętrzny przechowywany obok serwera nie chroni przed zalaniem, pożarem ani atakiem ransomware, który szyfruje wszystkie podłączone nośniki. Plan określa, gdzie przechowywać dodatkową kopię poza siedzibą, jak często ją aktualizować i — co równie istotne — jak z niej przywrócić dane krok po kroku, gdy osoba wykonująca przywracanie nie jest tą, która kopię konfigurała.
Nawet jeśli infrastruktura pozostaje stabilna, warto weryfikować plan co pół roku — choćby po to, by upewnić się, że kopie zapasowe nadal się wykonują poprawnie, dane logowania są aktualne i wyznaczone osoby kontaktowe są nadal dostępne. Przegląd pogwarancyjny planu jest bezpłatny.
Wycena zależy od wielkości i złożoności infrastruktury. Diagnoza wstępna i oszacowanie zakresu prac są bezpłatne — serwisant dojeżdża do firmy, ocenia środowisko i przedstawia wycenę przed rozpoczęciem prac. Nie obowiązują dodatkowe opłaty za dojazd w weekendy, noce czy dni świąteczne.
Plan ciągłości działania bywa mylony z bieżącym administrowaniem serwerami lub z jednorazową konfiguracją backupu. To jednak różne usługi. Samo skonfigurowanie kopii zapasowej — bez analizy priorytetów, bez procedur przywracania, bez wyznaczenia osób odpowiedzialnych — nie stanowi planu ciągłości. Podobnie regularna administracja (aktualizacje, monitoring, zarządzanie kontami) zapewnia bieżące działanie systemów, ale nie odpowiada na pytanie, co robić, gdy dojdzie do zdarzenia wykraczającego poza normalną eksploatację.
Plan disaster recovery uzupełnia obie te usługi — zakłada, że mimo prawidłowej administracji i mimo działających kopii zapasowych może dojść do sytuacji wymagającej skoordynowanej reakcji. Jego wartość ujawnia się właśnie wtedy, gdy coś pójdzie nie tak mimo zachowania standardowych środków ostrożności.
Większość firm, które zgłaszają się po pomoc w odzyskaniu danych lub przywróceniu serwera, robi to już po fakcie — gdy system nie działa, a pracownicy czekają. Przygotowanie planu ciągłości działania z wyprzedzeniem pozwala zamienić chaotyczną reakcję w uporządkowaną procedurę, w której każdy krok jest z góry określony. Aby omówić zakres planu dopasowanego do konkretnej infrastruktury, wystarczy kontakt telefoniczny pod numer 22 378 48 09 — linia jest dostępna całą dobę, siedem dni w tygodniu.